Vision and Learning Lab

Clemson University

2026

Lang-SVG: Hierarchical Image Vectorization with Language Priors

Xi Liu, Chaoyi Zhou, Run Wang, Jiaang Li, Feng Luo, Junxiang Huang, Siyu Huang

NeurIPS, 2026

Figure from Language-Conditioned World Modeling for Visual Navigation

Language-Conditioned World Modeling for Visual Navigation

Yifei Dong, Fengyi Wu, Yilong Dai, Lingdong Kong, Guangyu Chen, Qiyu Hu, Yetong Sha, Feng Liu, Siyu Huang, Qi Dai, Zhi-Qi Cheng

NeurIPS, 2026   (Oral)

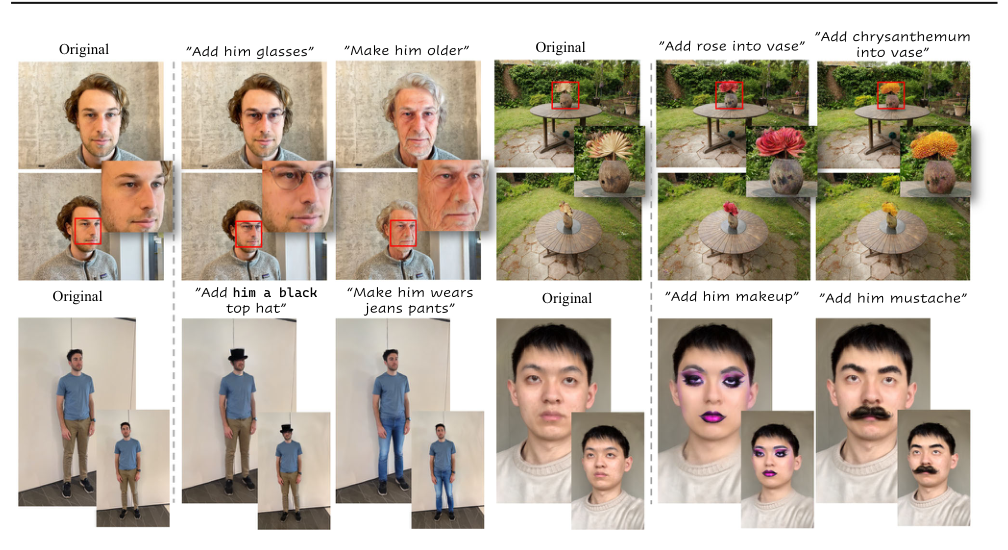
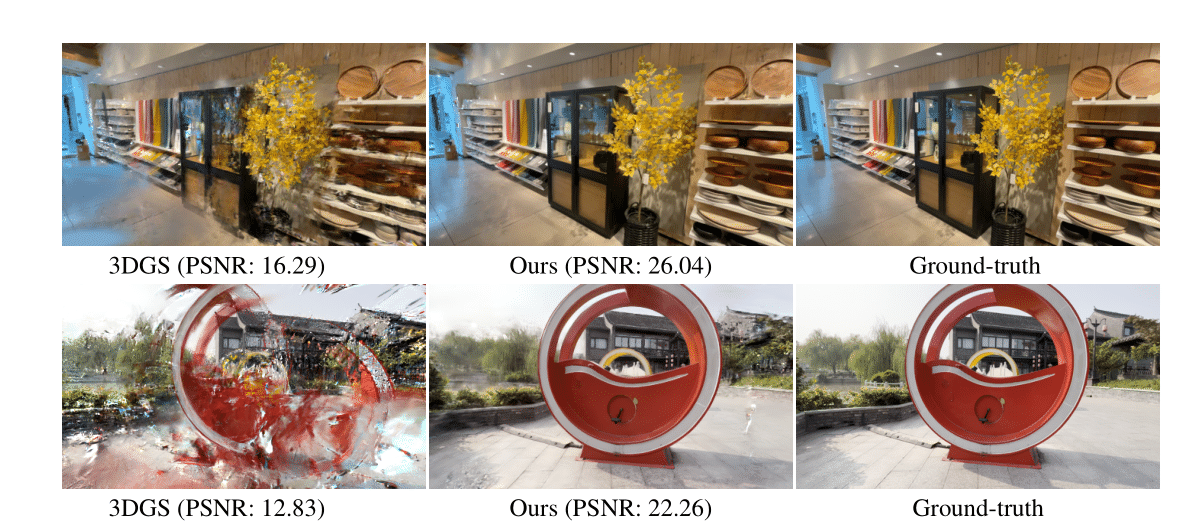
Figure from Mastering Regional 3DGS: Locating, Initializing, and Editing with Diverse 2D Priors

Mastering Regional 3DGS: Locating, Initializing, and Editing with Diverse 2D Priors

Lanqing Guo, Yufei Wang, Hezhen Hu, Yan Zheng, Yeying Jin, Siyu Huang, Zhangyang Wang

IJCV, 2026

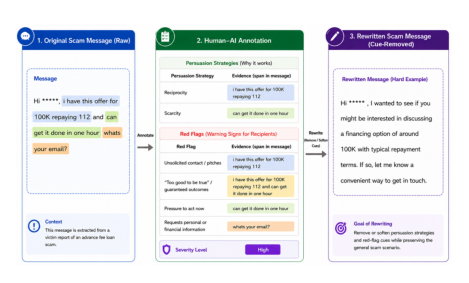
Figure from ScamBench: A Multi-Dimensional Scam Benchmark through Human-AI Collaborative Data Construction

ScamBench: A Multi-Dimensional Scam Benchmark through Human-AI Collaborative Data Construction

Huaye Li, Siyu Huang, Jinkyung Katie Park

Findings of EMNLP, 2026

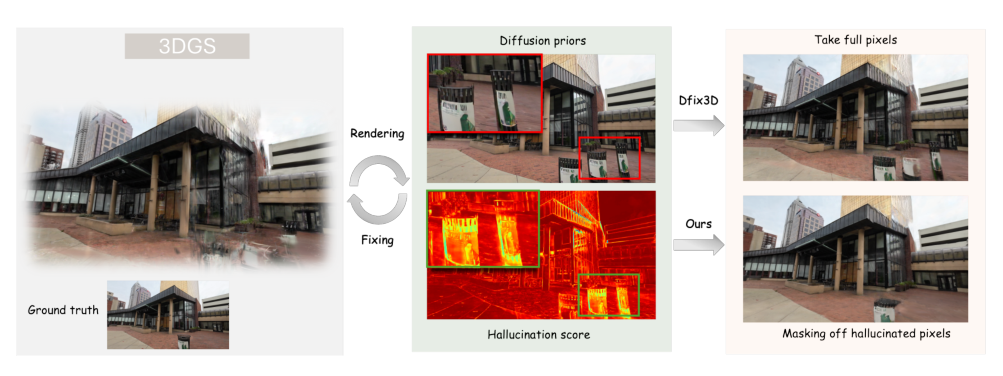
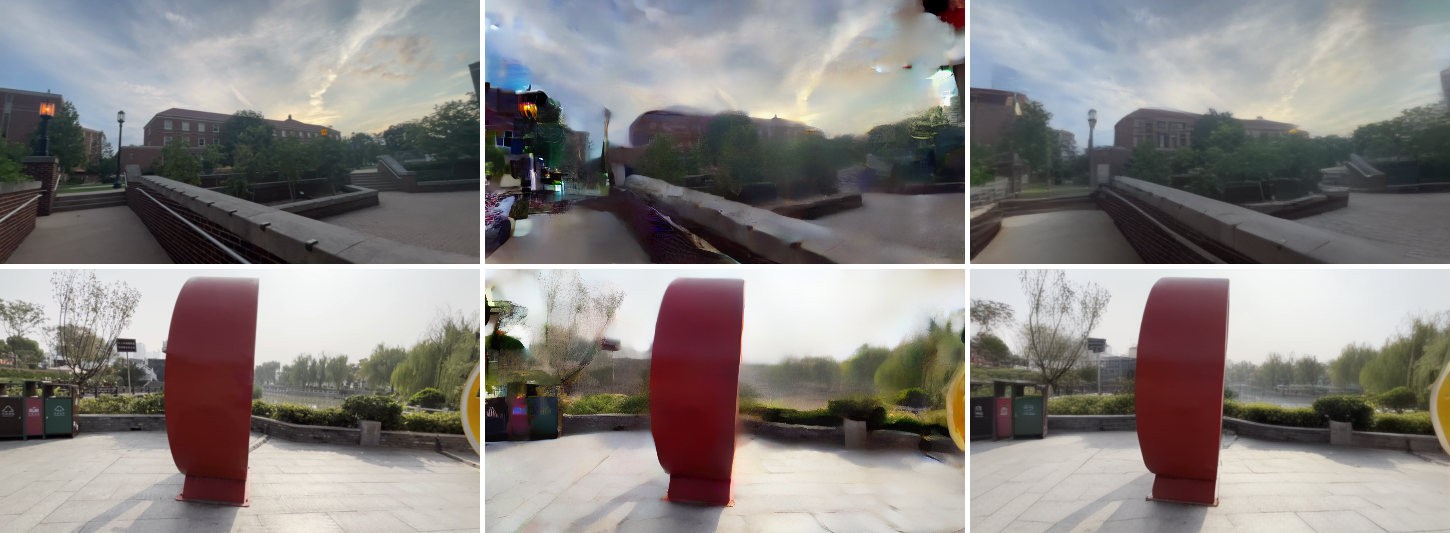
Figure from HAD: Hallucination-Aware Diffusion Priors for 3D Reconstruction

HAD: Hallucination-Aware Diffusion Priors for 3D Reconstruction

Xi Liu, Weiwei Sun, Zhou Ren, Chris Broaddus, Siyu Huang, Laurent Guigues

CVPR, 2026

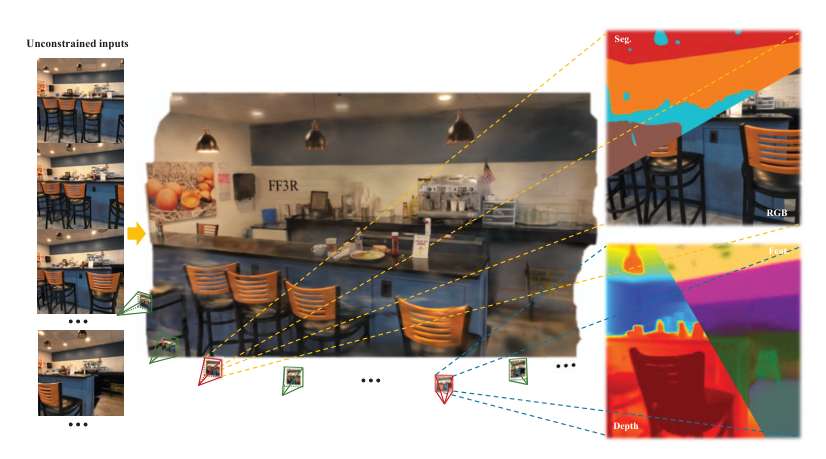
Figure from FF3R: Feedforward Feature 3D Reconstruction from Unconstrained Views

FF3R: Feedforward Feature 3D Reconstruction from Unconstrained Views

Chaoyi Zhou, Run Wang, Feng Luo, Mert D. Pesé, Zhiwen Fan, Yiqi Zhong, Siyu Huang

CVPR Findings, 2026

Figure from Fundus to Fluorescein Angiography Video Generation as a Retinal Generative Foundation Model

Fundus to Fluorescein Angiography Video Generation as a Retinal Generative Foundation Model

Weiyi Zhang, Jiancheng Yang, Ruoyu Chen, Siyu Huang, Pusheng Xu, Xiaolan Chen, Zhenhan Wang, Shanfu Lu, Hongyu Cao, Xianwen Shang, Danli Shi, Mingguang He

npj Digital Medicine, 2026

Figure from Fast 2DGS: Efficient Image Representation with Deep Gaussian Prior

Fast 2DGS: Efficient Image Representation with Deep Gaussian Prior

Hao Wang, Ashish Bastola, Chaoyi Zhou, Wenhui Zhu, Xiwen Chen, Xuanzhao Dong, Siyu Huang, Abolfazl Razi

WACV 5th Workshop on Image/Video/Audio Quality Assessment in Computer Vision, VLM and Diffusion Model, 2026

Figure from Bonnet: Ultra-Fast Whole-Body Bone Segmentation from CT Scans

Bonnet: Ultra-Fast Whole-Body Bone Segmentation from CT Scans

Hanjiang Zhu, Pedro Martelleto Rezende, Zhang Yang, Tong Ye, Bruce Z. Gao, Feng Luo, Siyu Huang, Jiancheng Yang

IEEE International Symposium on Biomedical Imaging (ISBI), 2026

Figure from Synthetic Melanoma Image Generation and Evaluation Using Generative Adversarial Networks

Synthetic Melanoma Image Generation and Evaluation Using Generative Adversarial Networks

Pei-Yu Lin, Yidan Shen, Neville Mathew, Renjie Hu, Siyu Huang, Courtney M. Queen, Cameron E. West, Ana Ciurea, George Zouridakis

Bioengineering, 2026

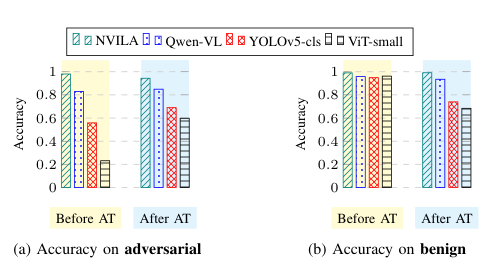
Figure from Toward Inherently Robust VLMs Against Visual Perception Attacks

Toward Inherently Robust VLMs Against Visual Perception Attacks

Pedram Mohajer Ansari, Amir Salarpour, Michael Kühr, Siyu Huang, Mohammad Hamad, Habeeb Olufowobi, Sebastian Steinhorst, Bing Li, Mert Pesé

IEEE Intelligent Vehicles Symposium (IV), 2026

2025

Figure from A Multimodal Visual–Language Foundation Model for Computational Ophthalmology

A Multimodal Visual–Language Foundation Model for Computational Ophthalmology

Danli Shi, Weiyi Zhang, Jiancheng Yang, Siyu Huang, Xiaolan Chen, Mayinuer Yusufu, Kai Jin, Shan Lin, Shunming Liu, Qing Zhang, Mingguang He

npj Digital Medicine, 2025

Publication Image

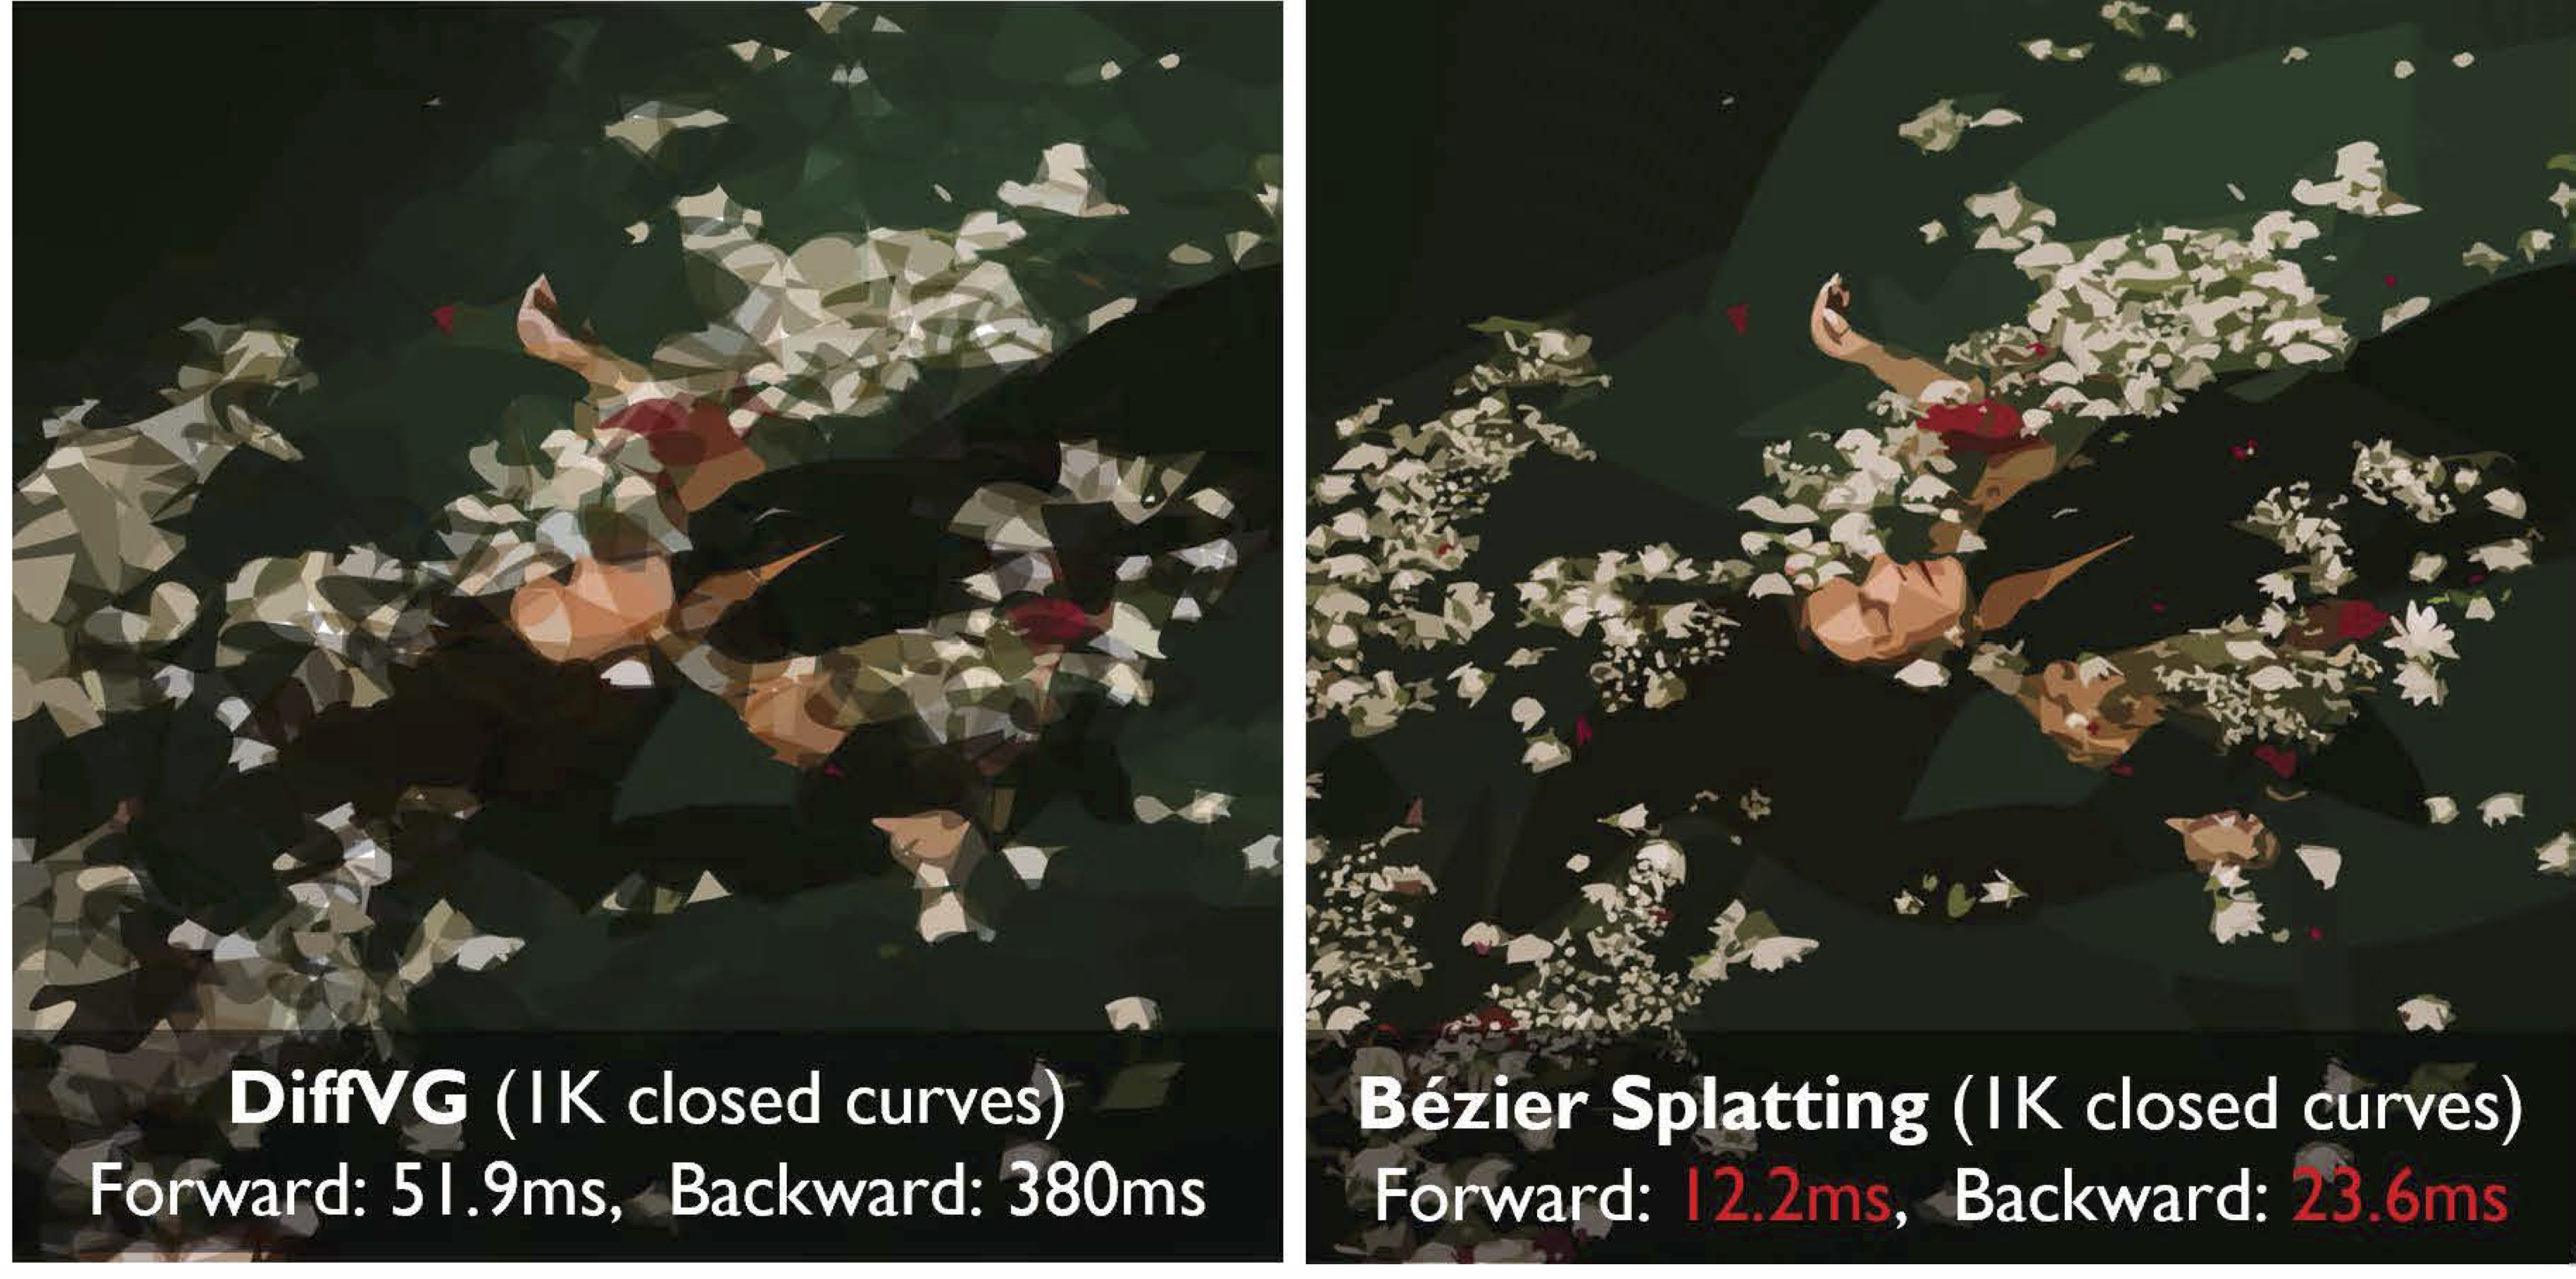
Bézier Splatting for Fast and Differentiable Vector Graphics Rendering

Xi Liu, Chaoyi Zhou, Nanxuan Zhao, Siyu Huang

NeurIPS, 2025  

Publication Image

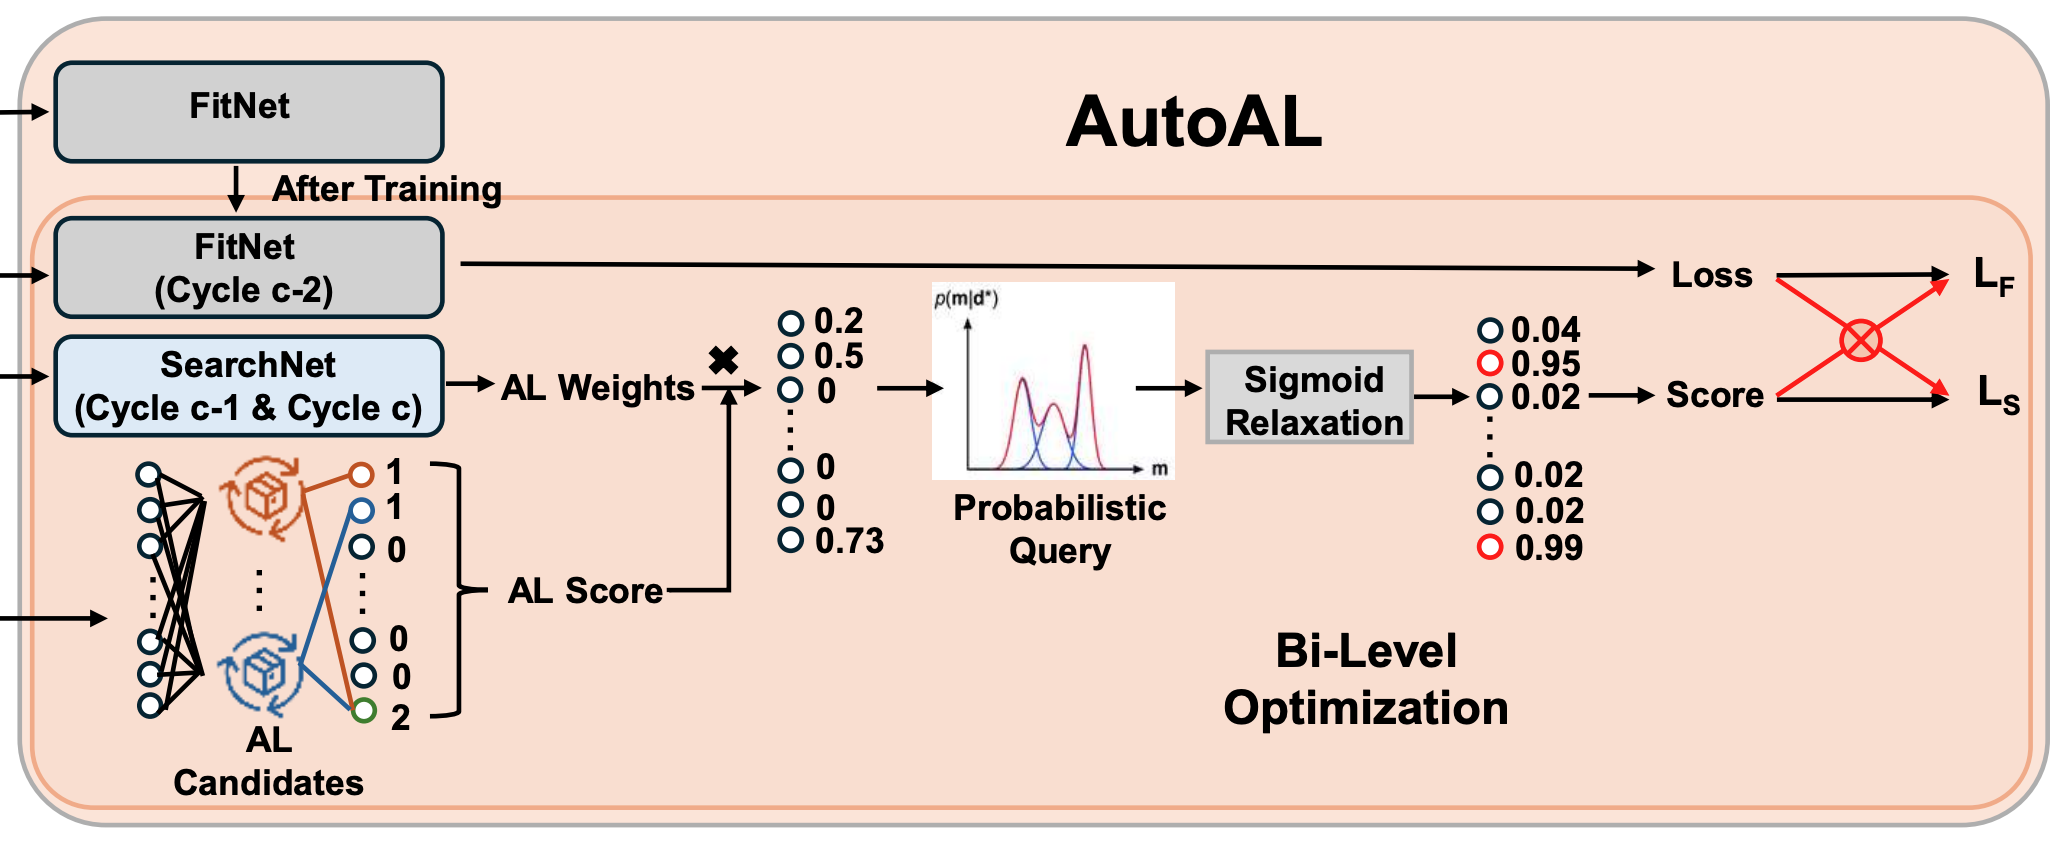
AutoAL: Automated Active Learning with Differentiable Query Strategy Search

Yifeng Wang, Xueying Zhan, Siyu Huang

ICML, 2025  

Publication Image

SoftShadow: Leveraging Soft Masks for Penumbra-Aware Shadow Removal

Xinrui Wang, Lanqing Guo, Xiyu Wang, Siyu Huang, Bihan Wen

CVPR, 2025  

Publication Image

Latent Radiance Fields with 3D-aware 2D Representations

Chaoyi Zhou*, Xi Liu*, Feng Luo, Siyu Huang

ICLR, 2025  

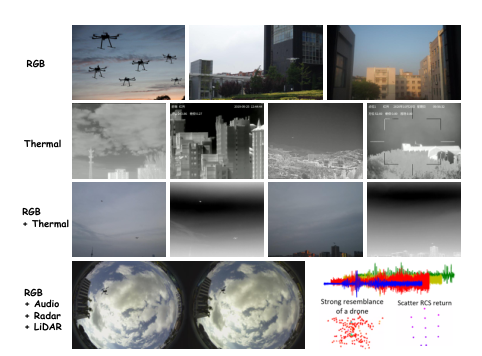
Figure from Securing the Skies: A Comprehensive Survey on Anti-UAV Methods, Benchmarking, and Future Directions

Securing the Skies: A Comprehensive Survey on Anti-UAV Methods, Benchmarking, and Future Directions

Yifei Dong, Fengyi Wu, Sanjian Zhang, Guangyu Chen, Yuzhi Hu, Masumi Yano, Jingdong Sun, Siyu Huang, Feng Liu, Qi Dai, Zhi-Qi Cheng

CVPR 4th Anti-UAV Workshop, 2025   (Best Paper)
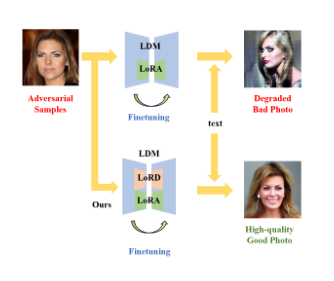
Figure from LoRD: A Low-Rank Defense Method for Adversarial Attack on Diffusion Models

LoRD: A Low-Rank Defense Method for Adversarial Attack on Diffusion Models

Jiaxuan Zhu, Siyu Huang

IEEE International Conference on Multimedia and Expo (ICME), 2025

Figure from Few-Shot Generalized Category Discovery With Retrieval-Guided Decision Boundary Enhancement

Few-Shot Generalized Category Discovery With Retrieval-Guided Decision Boundary Enhancement

Yunhan Ren, Feng Luo, Siyu Huang

ACM International Conference on Multimedia Retrieval (ICMR), 2025

2024

Publication Image

3DGS-Enhancer: Enhancing Unbounded 3D Gaussian Splatting with View-consistent 2D Diffusion Priors

Xi Liu*, Chaoyi Zhou*, Siyu Huang

NeurIPS, 2024   (Spotlight)

Figure from Make a Cheap Scaling: A Self-Cascade Diffusion Model for Higher-Resolution Adaptation

Make a Cheap Scaling: A Self-Cascade Diffusion Model for Higher-Resolution Adaptation

Lanqing Guo, Yingqing He, Haoxin Chen, Menghan Xia, Xiaodong Cun, Yufei Wang, Siyu Huang, Yong Zhang, Xintao Wang, Qifeng Chen, Ying Shan, Bihan Wen

ECCV, 2024  

Figure from Fundus2Video: Cross-Modal Angiography Video Generation from Static Fundus Photography with Clinical Knowledge Guidance

Fundus2Video: Cross-Modal Angiography Video Generation from Static Fundus Photography with Clinical Knowledge Guidance

Weiyi Zhang, Siyu Huang, Jiancheng Yang, Ruoyu Chen, Zongyuan Ge, Yingfeng Zheng, Danli Shi, Mingguang He

MICCAI, 2024  

Figure from MTPret: Improving X-ray Image Analytics with Multi-Task Pre-training

MTPret: Improving X-ray Image Analytics with Multi-Task Pre-training

Weibin Liao, Qingzhong Wang, Xuhong Li, Yi Liu, Zeyu Chen, Siyu Huang, Dejing Dou, Yanwu Xu, Haoyi Xiong

IEEE Transactions on Artificial Intelligence (TAI), 2024  
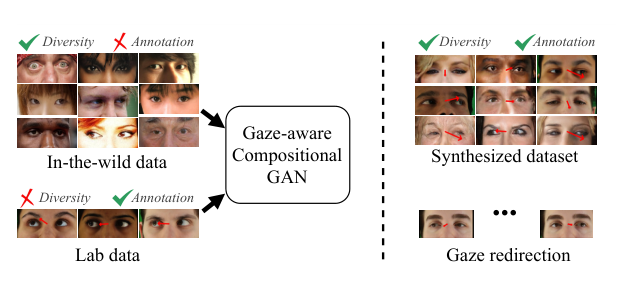
Figure from Learning Gaze-aware Compositional GAN from Limited Annotations

Learning Gaze-aware Compositional GAN from Limited Annotations

Nerea Aranjuelo Ansa, Siyu Huang, Ignacio Arganda-Carreras, Luis Unzueta Irurtia, Oihana Otaegui Madurga, Hanspeter Pfister, Donglai Wei

ACM Symposium of Eye Tracking Research & Applications (ETRA), 2024  

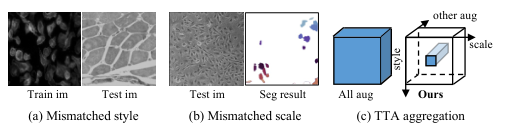
Figure from S3-TTA: Scale-Style Selection for Test-Time Augmentation in Biomedical Image Segmentation

S3-TTA: Scale-Style Selection for Test-Time Augmentation in Biomedical Image Segmentation

Kangxian Xie, Siyu Huang, Sebastian Andres Cajas Ordonez, Hanspeter Pfister, Donglai Wei

IEEE International Symposium on Biomedical Imaging (ISBI), 2024  

2023

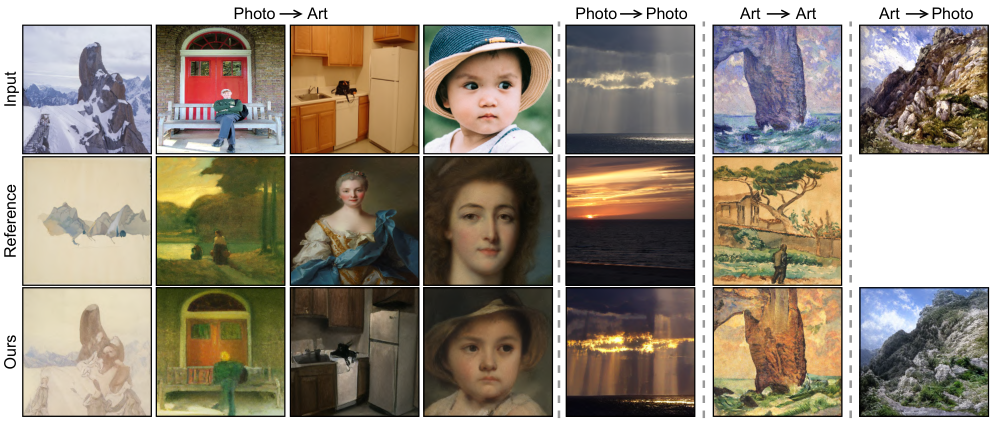
Figure from Domain-Scalable Unpaired Image Translation via Latent Space Anchoring

Domain-Scalable Unpaired Image Translation via Latent Space Anchoring

Siyu Huang*, Jie An*, Donglai Wei, Zudi Lin, Jiebo Luo, Hanspeter Pfister

IEEE Transactions on Pattern Analysis and Machine Intelligence (TPAMI), 2023  

Figure from QuantArt: Quantizing Image Style Transfer Towards High Visual Fidelity

QuantArt: Quantizing Image Style Transfer Towards High Visual Fidelity

Siyu Huang*, Jie An*, Donglai Wei, Jiebo Luo, Hanspeter Pfister

IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2023  

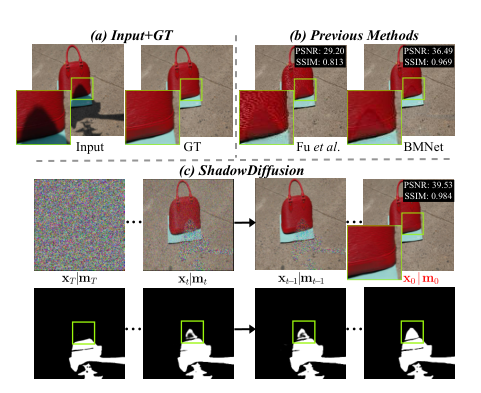
Figure from ShadowDiffusion: When Degradation Prior Meets Diffusion Model for Shadow Removal

ShadowDiffusion: When Degradation Prior Meets Diffusion Model for Shadow Removal

Lanqing Guo, Chong Wang, Wenhan Yang, Siyu Huang, Yufei Wang, Hanspeter Pfister, Bihan Wen

IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2023  

Figure from ShadowFormer: Global Context Helps Shadow Removal

ShadowFormer: Global Context Helps Shadow Removal

Lanqing Guo, Siyu Huang, Ding Liu, Hao Cheng, Bihan Wen

AAAI Conference on Artificial Intelligence (AAAI), 2023  

Figure from Towards Robust Image Denoising via Flow-based Joint Image and Noise Model

Towards Robust Image Denoising via Flow-based Joint Image and Noise Model

Lanqing Guo, Siyu Huang, Haosen Liu, and Bihan Wen

IEEE Transactions on Circuits and Systems for Video Technology (TCSVT), 2023  
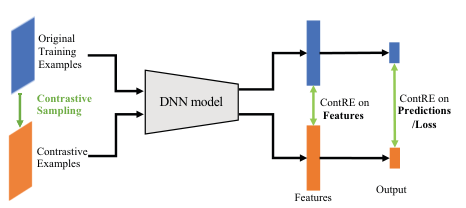
Figure from ContRE: A Complementary Measure for Robustness Evaluation of Deep Networks via Contrastive Examples

ContRE: A Complementary Measure for Robustness Evaluation of Deep Networks via Contrastive Examples

Xuhong Li, Xuanyu Wu, Linghe Kong, Xiao Zhang, Siyu Huang, Dejing Dou, and Haoyi Xiong

IEEE International Conference on Data Mining (ICDM), 2023  

Figure from 3D Domain Adaptive Instance Segmentation via Cyclic Segmentation GANs

3D Domain Adaptive Instance Segmentation via Cyclic Segmentation GANs

Leander Lauenburg, Zudi Lin, Ruihan Zhang, Marcia dos Santos, Siyu Huang, Ignacio Arganda-Carreras, Edward S. Boyden, Hanspeter Pfister, Donglai Wei

IEEE Journal of Biomedical and Health Informatics (JBHI), 2023  
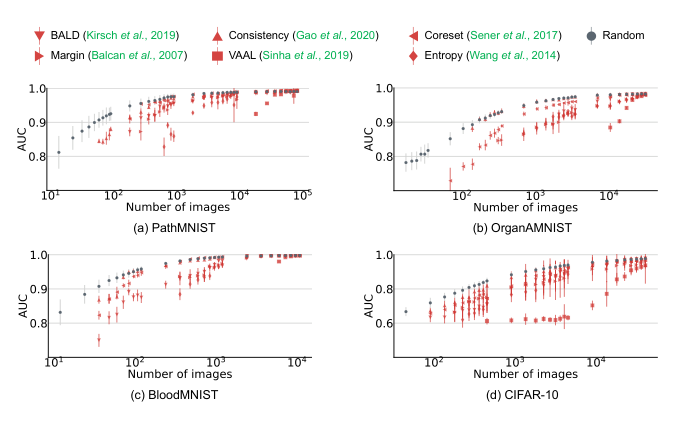
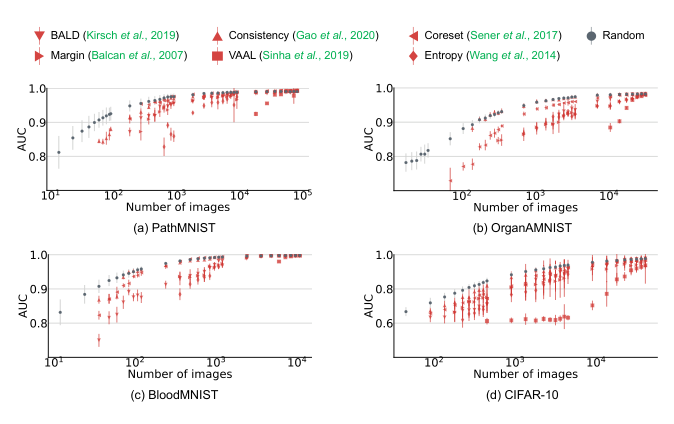
Figure from Making Your First Choice: To Address Cold Start Problem in Vision Active Learning

Making Your First Choice: To Address Cold Start Problem in Vision Active Learning

Liangyu Chen, Yutong Bai, Siyu Huang, Yongyi Lu, Bihan Wen, Alan Yuille, Zongwei Zhou

Medical Imaging with Deep Learning (MIDL), 2023  

Figure from Cross-Model Consensus of Explanations and Beyond for Image Classification Models: An Empirical Study

Cross-Model Consensus of Explanations and Beyond for Image Classification Models: An Empirical Study

Xuhong Li, Haoyi Xiong, Siyu Huang, Shilei Ji, Dejing Dou

Machine Learning, European Conference on Machine Learning 2022 journal track (MLJ), 2023  

2022

Figure from Temporal Output Discrepancy for Loss Estimation-based Active Learning

Temporal Output Discrepancy for Loss Estimation-based Active Learning

Siyu Huang, Tianyang Wang, Haoyi Xiong, Bihan Wen, Jun Huan, Dejing Dou

IEEE Transactions on Neural Networks and Learning Systems (TNNLS), 2022  

Figure from MUSCLE: Multi-task Self-supervised Continual Learning to Pre-train Deep Models for X-ray Images of Multiple Body Parts

MUSCLE: Multi-task Self-supervised Continual Learning to Pre-train Deep Models for X-ray Images of Multiple Body Parts

Weibin Liao, Haoyi Xiong, Qingzhong Wang, Yan Mo, Xuhong Li, Yi Liu, Zeyu Chen, Siyu Huang, Dejing Dou

Medical Image Computing and Computer Assisted Intervention (MICCAI), 2022  
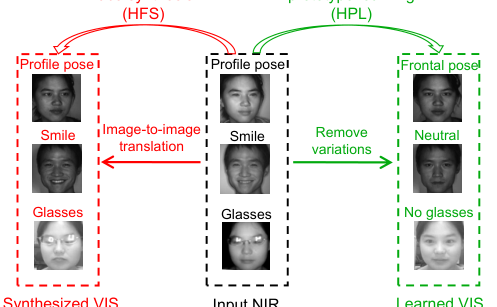
Figure from A Unified Framework for Bidirectional Prototype Learning from Contaminated Faces across Heterogeneous Domains

A Unified Framework for Bidirectional Prototype Learning from Contaminated Faces across Heterogeneous Domains

Meng Pang, Binghui Wang, Siyu Huang, Yiu-ming Cheung, Bihan Wen

IEEE Transactions on Information Forensics and Security (TIFS), 2022  

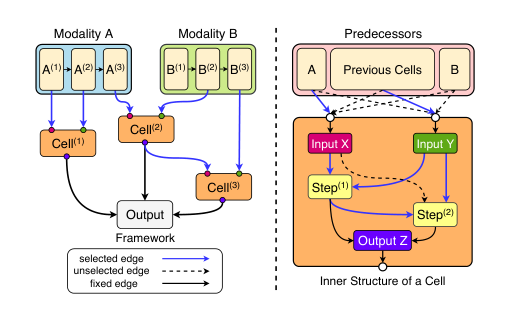
Figure from BM-NAS: Bilevel Multimodal Neural Architecture Search

BM-NAS: Bilevel Multimodal Neural Architecture Search

Yihang Yin, Siyu Huang, Xiang Zhang

AAAI Conference on Artificial Intelligence (AAAI), 2022   (Oral)

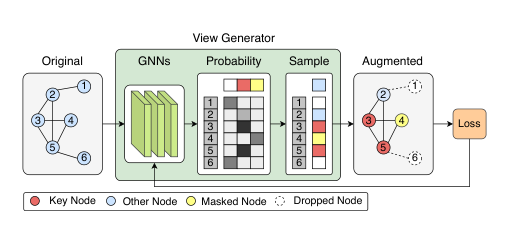
Figure from AutoGCL: Automated Graph Contrastive Learning via Learnable View Generators

AutoGCL: Automated Graph Contrastive Learning via Learnable View Generators

Yihang Yin, Qingzhong Wang, Siyu Huang, Haoyi Xiong, Xiang Zhang

AAAI Conference on Artificial Intelligence (AAAI), 2022  

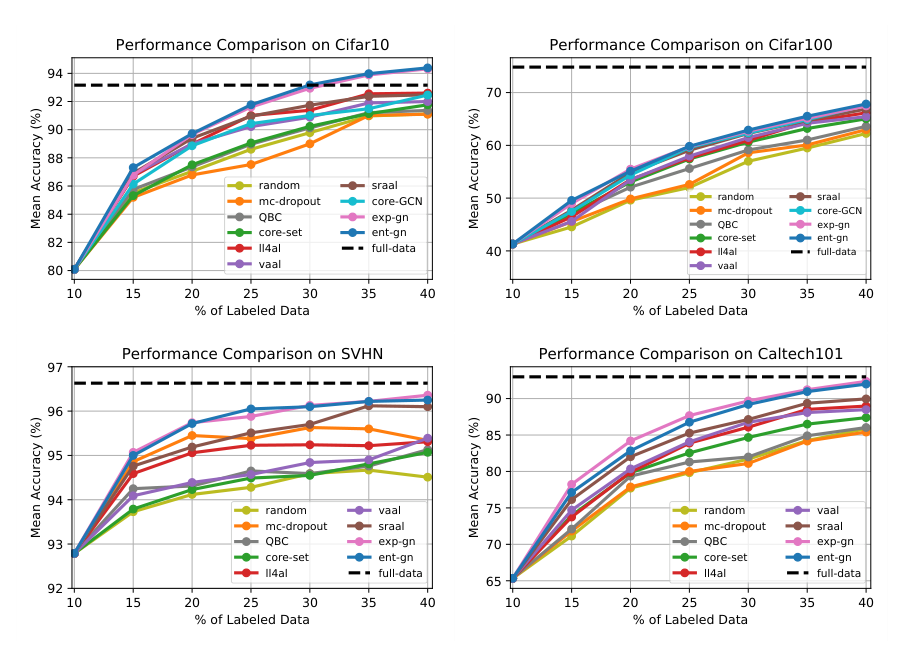
Figure from Boosting Active Learning via Improving Test Performance

Boosting Active Learning via Improving Test Performance

Tianyang Wang, Xingjian Li, Pengkun Yang, Guosheng Hu, Xiangrui Zeng, Siyu Huang, Cheng-Zhong Xu, Min Xu

AAAI Conference on Artificial Intelligence (AAAI), 2022  

Figure from A Guide to Your First Choice: Addressing Cold Start Problem in Vision Active Learning

A Guide to Your First Choice: Addressing Cold Start Problem in Vision Active Learning

Liangyu Chen, Yutong Bai, Siyu Huang, Yongyi Lu, Bihan Wen, Alan Yuille, Zongwei Zhou

NeurIPS Workshop on Human in the Loop Learning, 2022

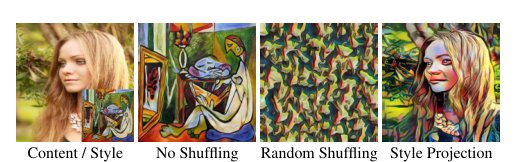
Figure from Parameter-Free Style Projection for Arbitrary Style Transfer

Parameter-Free Style Projection for Arbitrary Style Transfer

Siyu Huang, Haoyi Xiong, Tianyang Wang, Bihan Wen, Qingzhong Wang, Zeyu Chen, Jun Huan, Dejing Dou

International Conference on Acoustics, Speech, and Signal Processing (ICASSP), 2022  

2021
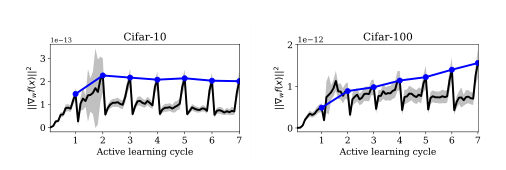
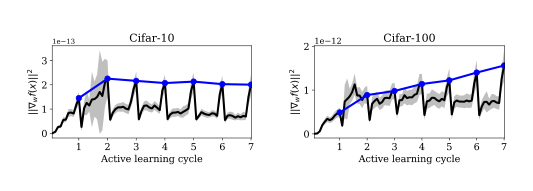
Figure from Semi-Supervised Active Learning with Temporal Output Discrepancy

Semi-Supervised Active Learning with Temporal Output Discrepancy

Siyu Huang, Tianyang Wang, Haoyi Xiong, Jun Huan, Dejing Dou

International Conference on Computer Vision (ICCV), 2021  

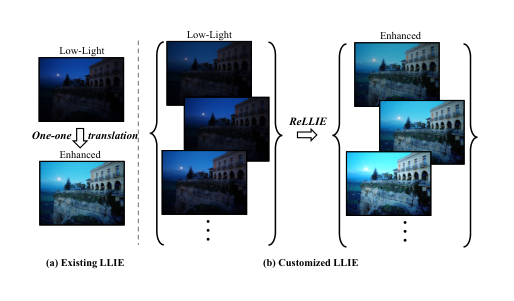
Figure from ReLLIE: Deep Reinforcement Learning for Customized Low-Light Image Enhancement

ReLLIE: Deep Reinforcement Learning for Customized Low-Light Image Enhancement

Rongkai Zhang, Lanqing Guo, Siyu Huang, Bihan Wen

ACM International Conference on Multimedia (ACM MM), 2021  

Figure from ArtFlow: Unbiased Image Style Transfer via Reversible Neural Flows

ArtFlow: Unbiased Image Style Transfer via Reversible Neural Flows

Jie An*, Siyu Huang*, Yibing Song, Dejing Dou, Wei Liu, Jiebo Luo

IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2021  

An Investigation of Containment Measure Implementation and Public Responses to the COVID-19 Pandemic in Mainland China

Ji Liu, Haoyi Xiong, Xiakai Wang, Jizhou Huang, Qiaojun Li, Tongtong Huang, Siyu Huang, Haifeng Wang, Dejing Dou

IEEE International Conference on Digital Health (ICDH), 2021  

2020 and earlier
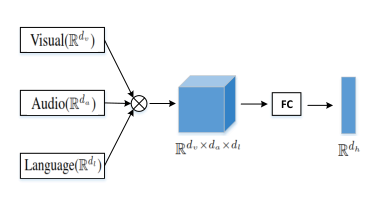
Figure from Dual Low-Rank Multimodal Fusion

Dual Low-Rank Multimodal Fusion

Tao Jin*, Siyu Huang*, Yingming Li, Zhongfei Zhang

Findings of the Association for Computational Linguistics: EMNLP (EMNLP Findings), 2020  
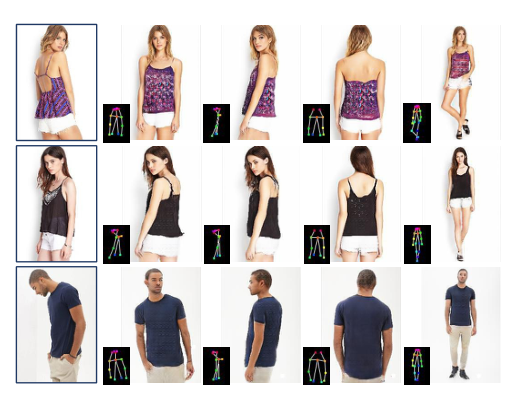
Figure from Generating Person Images with Appearance-aware Pose Stylizer

Generating Person Images with Appearance-aware Pose Stylizer

Siyu Huang, Haoyi Xiong, Zhi-Qi Cheng, Qingzhong Wang, Xingran Zhou, Bihan Wen, Jun Huan, Dejing Dou

International Joint Conference on Artificial Intelligence (IJCAI), 2020  
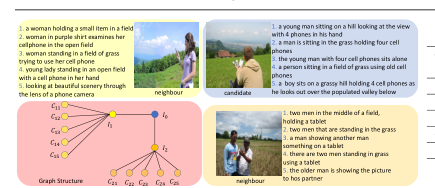
Figure from SBAT: Video Captioning with Sparse Boundary-Aware Transformer

SBAT: Video Captioning with Sparse Boundary-Aware Transformer

Tao Jin, Siyu Huang, Ming Chen, Yingming Li, Zhongfei Zhang

International Joint Conference on Artificial Intelligence (IJCAI), 2020  

Figure from Neighbours Matter: Image Captioning with Similar Images

Neighbours Matter: Image Captioning with Similar Images

Qingzhong Wang, Jiuniu Wang, Antoni Chan, Siyu Huang, Haoyi Xiong, Xingjian Li, Dejing Dou

British Machine Vision Conference (BMVC), 2020  
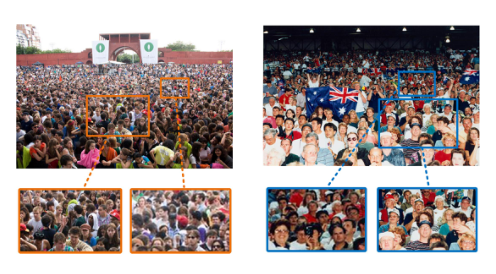
Figure from Stacked Pooling for Boosting Scale Invariance of Crowd Counting

Stacked Pooling for Boosting Scale Invariance of Crowd Counting

Siyu Huang, Xi Li, Zhi-Qi Cheng, Zhongfei Zhang, Alexander Hauptmann

International Conference on Acoustics, Speech, and Signal Processing (ICASSP), 2020  

Figure from Low-Rank HOCA: Efficient High-Order Cross-Modal Attention for Video Captioning

Low-Rank HOCA: Efficient High-Order Cross-Modal Attention for Video Captioning

Tao Jin, Siyu Huang*, Yingming Li, Zhongfei Zhang

Conference on Empirical Methods in Natural Language Processing (EMNLP), 2019  
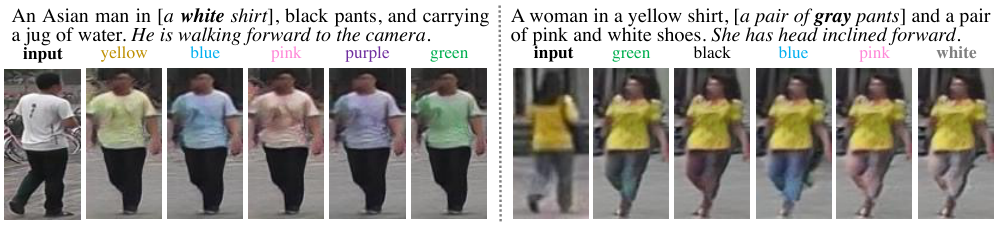
Figure from Text Guided Person Image Synthesis

Text Guided Person Image Synthesis

Xingran Zhou, Siyu Huang*, Bin Li, Yingming Li, Jiachen Li, Zhongfei Zhang

IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2019  

Figure from User-Ranking Video Summarization with Multi-Stage Spatio-Temporal Representation

User-Ranking Video Summarization with Multi-Stage Spatio-Temporal Representation

Siyu Huang, Xi Li, Zhongfei Zhang, Fei Wu, Junwei Han

IEEE Transactions on Image Processing (TIP), 2019  

Figure from GNAS: A Greedy Neural Architecture Search Method for Multi-Attribute Learning

GNAS: A Greedy Neural Architecture Search Method for Multi-Attribute Learning

Siyu Huang, Xi Li, Zhi-Qi Cheng, Zhongfei Zhang, Alexander Hauptmann

ACM International Conference on Multimedia (ACM MM), 2018 (Oral)  
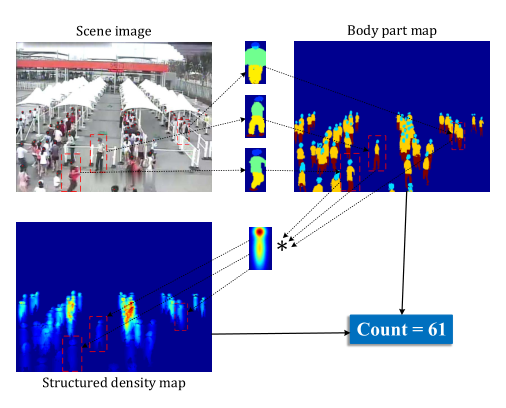
Figure from Learning to Transfer: Generalizable Attribute Learning with Multitask Neural Model Search

Learning to Transfer: Generalizable Attribute Learning with Multitask Neural Model Search

Zhi-Qi Cheng, Xiao Wu, Siyu Huang, Jun-Xiu Li, Alexander Hauptmann, Qiang Peng

ACM International Conference on Multimedia (ACM MM), 2018  
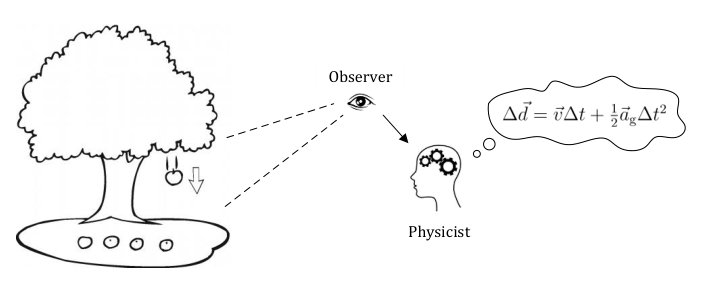
Figure from Body Structure Aware Deep Crowd Counting

Body Structure Aware Deep Crowd Counting

Siyu Huang, Xi Li, Zhongfei Zhang, Fei Wu, Shenghua Gao, Rongrong Ji, Junwei Han

IEEE Transactions on Image Processing (TIP), 2018  

Figure from Perceiving Physical Equation by Observing Visual Scenarios

Perceiving Physical Equation by Observing Visual Scenarios

Siyu Huang*, Zhi-Qi Cheng*, Xi Li, Xiao Wu, Zhongfei Zhang, Alexander Hauptmann

NeurIPS Workshop on Modeling the Physical World, 2018  

Figure from TVT: Two-View Transformer Network for Video Captioning

TVT: Two-View Transformer Network for Video Captioning

Ming Chen, Yingming Li, Zhongfei Zhang, Siyu Huang

Asian Conference on Machine Learning (ACML), 2018  
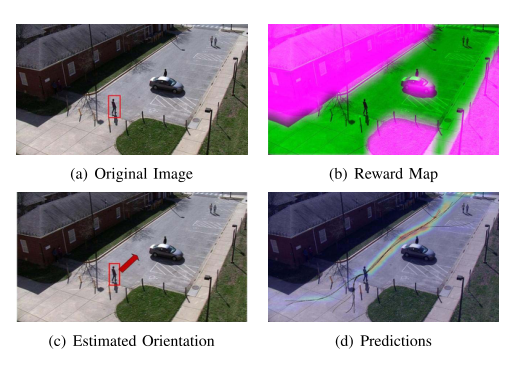
Figure from Deep Learning Driven Visual Path Prediction From a Single Image

Deep Learning Driven Visual Path Prediction From a Single Image

Siyu Huang, Xi Li, Zhongfei Zhang, Zhouzhou He, Fei Wu, Wei Liu, Jinhui Tang, Yueting Zhuang

IEEE Transactions on Image Processing (TIP), 2016   (Oral)